为什么"最小实验"是康莱德原型测试的核心
在康莱德创新挑战赛备赛过程中,团队需要在有限时间内完成从问题定义到商业计划书的完整闭环。许多参赛队伍容易陷入一个误区:试图在初稿中覆盖所有功能点,结果导致原型臃肿、假设模糊、反馈失真。
所谓"最小实验",是指用最低成本、最短时间,针对一个具体假设获取可量化的验证结果。这与康莱德评审材料中要求的"创新画布"和"创新简述"直接相关——评审需要看到团队对风险点的清醒认知,而非完美但未经检验的方案。
【教学说明:"康莱德原型测试"是本文用于备赛指导的教学概念,指将精益创业中的最小可行产品(MVP)思维应用于康莱德备赛过程。这不是康莱德官方赛事术语、评审标准或竞赛要求。】
【教学案例一】无人机精准施肥系统的核心假设验证
【说明:本案例为原创教学 illustration,基于 SoilSense SkyFarm 课题方向的公开招募信息重构,非官方赛题或真实团队数据。Source notes 中仅包含该课题的简要招募描述,未涉及具体实验设计或结果。】
假设某团队基于无人机智能闭环精准施肥系统方向,设计原型测试策略。该系统的商业叙事涉及:无人机搭载土壤传感器、自动多点采样、机器学习模型分析变量精准施肥。在原型测试阶段,团队面临关键决策:应该先验证哪个假设?
经过分析,团队识别出三个层级的假设:
- 技术可行性假设:土壤传感器在无人机振动环境下的数据稳定性
- 算法有效性假设:机器学习模型能否基于有限采样点预测整块农田的施肥需求
- 商业落地假设:农户是否愿意为降低的化肥成本支付系统服务费用
团队选择了算法有效性假设作为首个验证目标。理由:如果算法无法从稀疏采样中生成可靠决策,技术可行性和商业模式都无从谈起。最小实验设计如下:
在小型试验田中,团队用无人机按预设网格采集有限土壤样本点,同时用传统人工密集采样获取对照数据。实验目标不是构建完美模型,而是验证在采样点密度降低的情况下,模型预测值与对照数据的误差是否控制在可接受范围。
【教学要点】若误差在预设阈值内,团队获得继续迭代的信心,并将实验数据写入创新画布的"验证"板块;若误差超出阈值,团队需要回溯假设——是采样策略问题、特征选择问题,还是问题本身需要重新定义。这种快速失败、快速学习的机制,是康莱德评审看重的系统思维能力。
【教学案例二】智能防猝死系统的传感器融合验证
【说明:本案例为原创教学 illustration,基于"哨卫"智能防猝死系统方向的公开招募信息重构,非官方赛题或真实团队数据。Source notes 中仅包含该课题的简要招募描述,未涉及具体实验设计或结果。】
第二个教学案例来自多模态感知融合方向。该系统的核心创新在于:胸腹呼吸、脉搏血氧、鼾声三类信号的协同分析。团队面临的原型测试挑战更为复杂——单一传感器验证通过,不代表融合方案有效。
团队的最小实验聚焦于一个具体场景:在模拟睡眠环境中,系统能否在血氧饱和度下降至危险阈值前发出预警。这个假设直接关联产品的核心价值主张,而非边缘功能。
实验设计刻意保持"最小":使用简易外壳模拟枕头形态,集成现成脉搏血氧模块和麦克风,通过笔记本电脑运行初步的信号融合算法。团队招募志愿者进行模拟睡眠测试,记录假阳性率和漏报率。
【教学要点】关键洞察可能来自意外发现:当志愿者翻身导致传感器位移时,单一血氧信号出现中断,但融合鼾声频谱分析后,系统仍能维持有效监测。这类发现可被提炼为创新简述中的技术护城河描述,而非预先设计好的卖点。
【对比失误案例】跳过验证直接做全功能原型的后果
【说明:以下为原创教学 illustration,展示常见备赛失误及其工作后果】
某团队在备赛初期花费大量时间制作外观精美的产品渲染图和视频,却对核心假设的验证数据含糊其辞。当评审提问"你们如何证明这个算法在实际农田中有效"时,团队只能回答"我们相信可以优化"——这就是跳过假设验证、直接构建"演示原型"的典型后果。
失误的具体工作后果:该团队在初选答辩中,评审连续追问三个问题:传感器在真实农田光照条件下的信噪比数据、算法训练样本的来源与规模、以及与传统施肥方式的成本对比。由于团队未进行任何最小实验,所有回答都停留在推测层面。最终,该团队在创新画布的"验证"板块得分显著低于同组其他队伍,未能入围决选。
该团队的正确做法应该是:先用最小实验验证算法假设,确认可行后再逐步完善演示。具体修正路径为:用两周时间完成田间小样本测试,获取至少一组对照数据,再基于实验结果调整商业计划书中的技术参数和成本估算。
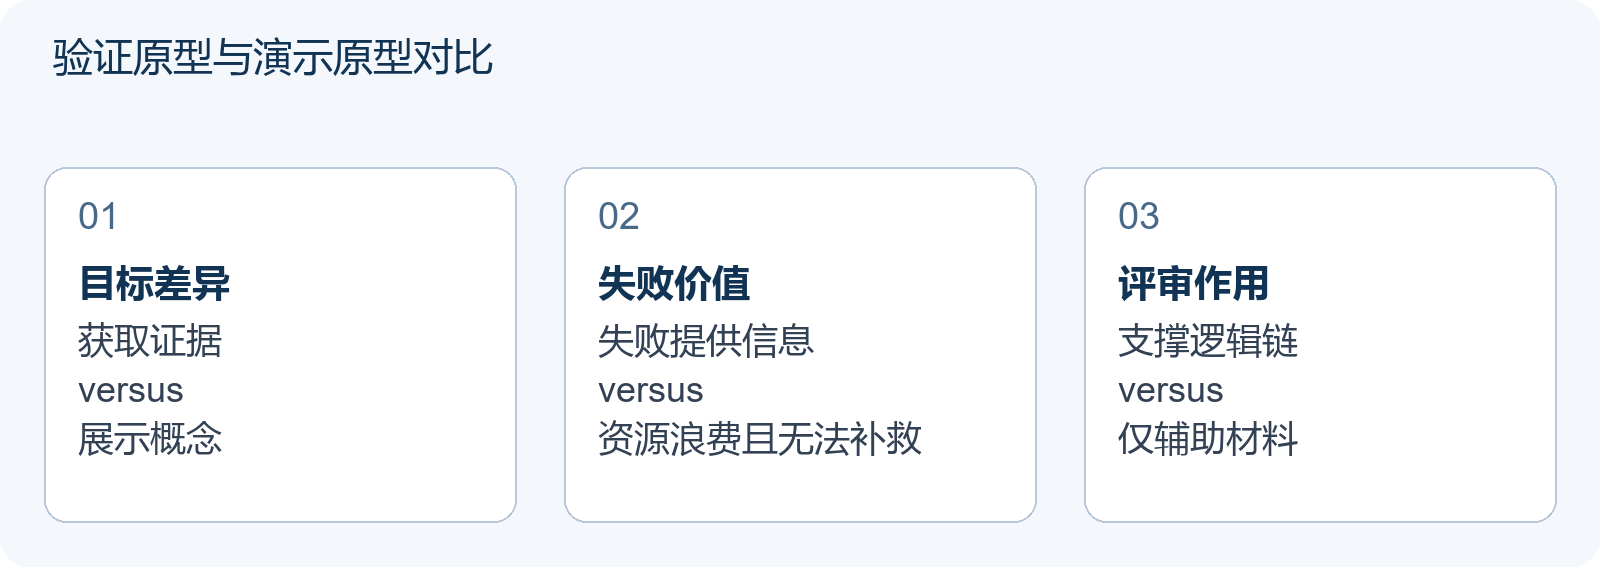
| 维度 | 验证原型 | 演示原型(失误做法) |
|---|---|---|
| 核心目标 | 获取证据,证伪或确认假设 | 展示概念,争取认同 |
| 投入重点 | 实验设计、数据采集、误差分析 | 视觉效果、叙事流畅度 |
| 失败价值 | 高——失败本身提供关键信息 | 低——失败意味着资源浪费且无法补救 |
| 康莱德评审适配度 | 直接支撑创新画布的逻辑链 | 仅作为辅助材料,不可替代验证 |
| 典型后果 | 即使假设被推翻,团队能快速调整方向 | 评审质疑时无数据支撑,答辩被动,可能初选淘汰 |
诊断方法:检查你的原型测试是否满足三个条件——有明确假设、有对照设计、有量化结论。若缺少任一要素,需要重新设计。
可操作的练习序列
基于上述教学案例,建议参赛团队按以下顺序推进原型测试:
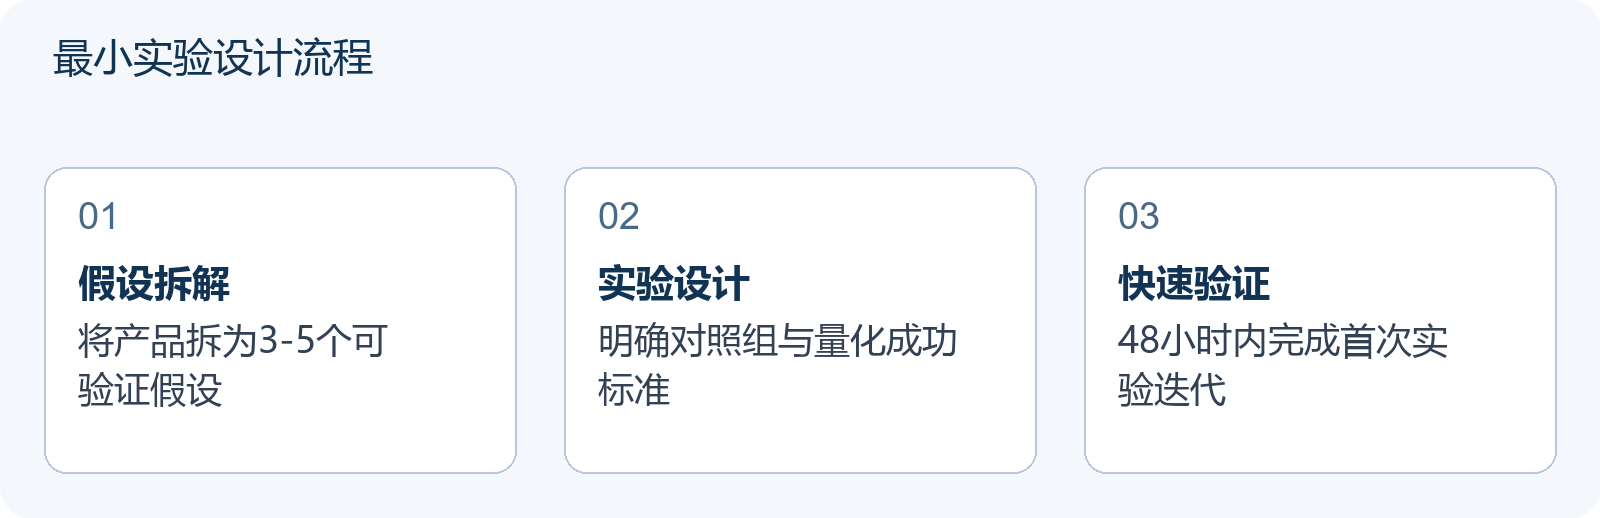
- 第一步:假设拆解。将产品愿景拆解为 3-5 个可独立验证的假设,按"若失败则项目不成立"的标准排序
- 第二步:最小实验设计。为最高优先级假设设计实验,明确成功标准和失败标准
- 第三步:48 小时快速验证。在两天内完成首次实验,记录原始数据和团队反思
- 第四步:迭代或转向。根据结果决定深化当前方向、调整假设,或重新定义问题
【时间提醒】根据 2026-2027 赛季康莱德中国站时间线,初选材料提交截止为 2026 年 12 月 25 日,团队需要在秋季完成核心假设的验证,才能为商业计划书和演示视频留出充分打磨时间。
下一步应该能做什么
完成本文阅读后,一个准备充分的康莱德参赛者应当能够:针对自己的课题方向,写出 3 个可验证的核心假设,并为每个假设设计一个可在 1 周内完成的最小实验。如果尚无法做到,说明需要回到问题定义阶段,而非急于推进原型制作。
关于康莱德创新挑战赛报名材料的整理方法,可参考康莱德报名材料怎么整理?初选提交物分类与上传自检;SDG 选题落地策略参见康莱德SDG选题怎么落地?从17个目标到具体项目题目;商业计划书财务部分的撰写指导可查阅康莱德商业计划书财务部分怎么写?收入成本与资金用途测算。
常见问题
最小实验需要做到什么程度才算"足够验证"?
足够验证的标准是:实验结果能够让你以较高置信度决定下一步行动。通常需要明确的成功阈值、可重复的操作流程,以及至少一组对照数据。不需要完美,但需要诚实记录局限性和不确定性。
如果核心假设验证失败,是否意味着要换课题?
不一定。首先区分是假设本身错误、实验设计缺陷,还是问题定义需要调整。康莱德评审欣赏的是团队对失败的反思和应对能力,而非一帆风顺的路径。记录失败并展示如何据此迭代,往往比回避问题更有说服力。
如何在创新画布中呈现尚未完成验证的假设?
使用"已验证/验证中/待验证"的分层标注,将已完成的最小实验结果作为证据,将计划中的验证与时间表一并列出。评审关注的是团队对风险的管理意识,而非所有假设都已解决的假象。